Este case é protegido. Digite a senha para continuar.

Product Design · Pesquisa · Teste de usabilidade · B2B · Web · SaaS
Redesenhando uma jornada de upload múltiplo que já tinha passado por rollback
Empresa
SaaS B2B de análise financeira
Duração
4 Semanas
Meu papel
Design de ponta a ponta: análises qualitativas e quantitativas transformadas em soluções visuais testáveis.
Equipe
1 Product designer; 1 Product Owner; 4 Engenheiros.
Problema
analistas enviavam dezenas de documentos por dia, um por vez, repetindo os mesmos dados em cada arquivo. Uma parcela relevante dos clientes apontou dificuldades com esse fluxo em pesquisa de satisfação.
O que mudou
Possibilidade de vários documentos enviados de uma vez, edição de campos em lote, replicação do identificador da empresa e campos complementares sob demanda, tudo em um fluxo similar aos que analistas já conheciam.
Restrições
•
Manter o modelo mental do fluxo de tela única que os analistas já usavam;
•
Limite de 5 PDFs por envio;
•
Uma primeira versão do upload múltiplo já tinha passado por rollback.
Nome da empresa, telas e dados foram alterados para preservar a confidencialidade. O processo e as decisões são reais.
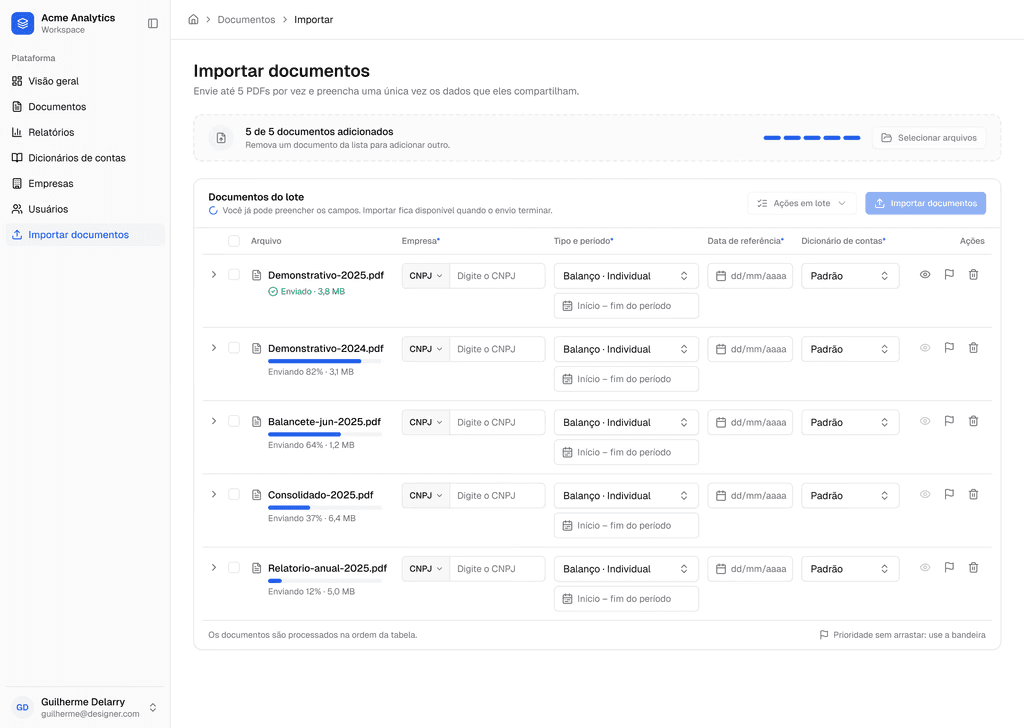
Nova tela de upload múltiplo
Contexto
Dezenas de documentos num dia. Um por vez. Para cada arquivo, o analista enviava o PDF e preenchia identificador da empresa, tipo do documento, período, configurações de leitura e mais uma fila de campos. Depois, o próximo. Muitas vezes com os mesmos dados, porque os documentos eram da mesma empresa.
Uma parcela relevante dos clientes apontou dificuldades com esse fluxo numa pesquisa de satisfação. A resposta parecia óbvia: deixar enviar vários arquivos de uma vez. Só que alguém já tinha tido essa ideia, e uma primeira versão não tinha se mantido em uso.
Então a pergunta interessante não era "como fazer upload múltiplo?". Era "o que a primeira versão já tinha descoberto?".
O formulário por trás de cada PDF
A plataforma lê documentos financeiros de empresas e organiza os dados para análise. Para ler um documento direito, ela precisa saber:
•
Quem é a empresa, normalmente pelo CNPJ;
•
O tipo do documento e o período que ele cobre;
•
As configurações de leitura do documento;
•
Dados complementares opcionais, como idioma, moeda e responsáveis pela revisão.
Um mesmo PDF pode trazer informações de mais de um ano. O analista escolhe processar tudo ou indica o que interessa. Também pode marcar um documento como prioritário.
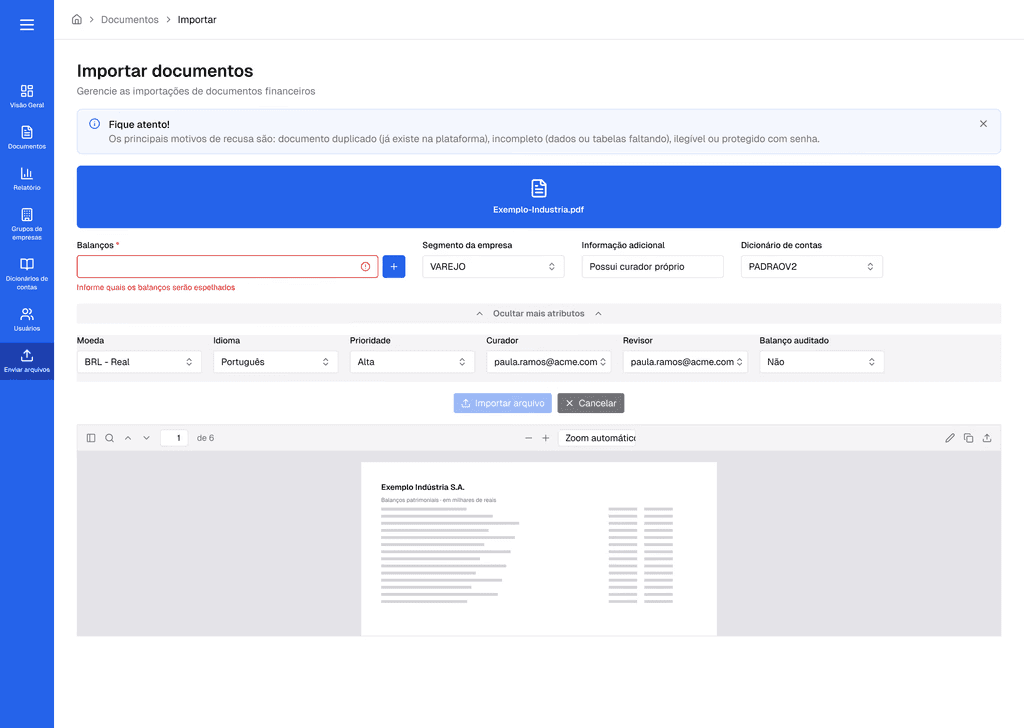
Fluxo anterior: um arquivo por vez, com o formulário completo e o PDF na mesma tela.
Para um arquivo, tudo bem. Para um lote da mesma empresa, a conta muda: o mesmo CNPJ digitado de novo, as mesmas configurações escolhidas de novo, uma nova chance de erro a cada volta. Digitar o mesmo CNPJ dezenas de vezes por dia tem algo de mantra, só que sem a paz interior.
O que a primeira tentativa ensinou
Dava para começar do zero. Achei mais útil entender o que aquela versão já sabia e eu ainda não. Fui conversar com pessoas da operação, que fazem esse processo todo dia, para entender como o trabalho acontecia na prática. A primeira versão do upload múltiplo foi desenhada, chegou aos usuários, passou por rollback, e a iniciativa foi pausada.
A demora era só parte da história. O fluxo de upload de arquivos original vivia numa única tela, com envio e preenchimento no mesmo lugar. A nova proposta separava a tarefa em etapas, uma tela para cada. A intenção fazia sentido: organizar o trabalho. Na prática, os usuários sentiam que andavam mais para fazer a mesma coisa.

Primeira tentativa: lista em etapas, com identificador e data separados dos demais campos.
Além disso, tive outros aprendizados:
•
Os campos obrigatórios não estavam visíveis na primeira visão;
•
Alguns campos importantes para a operação ainda não estavam contemplados;
•
Manipular os itens da lista precisava ficar mais simples;
•
Parte dos cenários só apareceu durante a implementação.
Somados, esses pontos fizeram a tarefa parecer mais longa do que no fluxo antigo. E deixaram um mapa claro do que o próximo desenho precisava resolver.
Foi aí que o projeto virou. Eu não precisava de um fluxo novo. Precisava melhorar o que já existia sem obrigar ninguém a reaprender o que já sabia fazer.
Dois princípios
Cortar a repetição.
Se vários arquivos são da mesma empresa, pedir os mesmos dados para cada um não faz sentido. A solução permite enviar vários PDFs de uma vez, editar campos em muitos documentos juntos e replicar dados compartilhados, como CNPJ e dicionário de contas. É a eficiência de uso, uma das heurísticas de Nielsen, em versão bem concreta: num lote de cinco documentos, digitar o CNPJ uma vez evita quatro digitações e quatro chances de erro.
Mexer sem mudar de endereço.
Mantive a estrutura que os analistas conheciam: uma tabela, um documento por linha, tudo na mesma tela. É a Lei de Jakob aplicada ao próprio produto. As pessoas esperam que uma interface funcione como as que já usam, e a que esses analistas conheciam melhor era justamente a anterior. Campos obrigatórios ficam na primeira visão; os seis complementares ficam numa linha expansível e só aparecem quando o analista precisa.
Fluxos, protótipo e teste
Comecei com rascunhos para mapear a jornada atual e explorar alternativas. Como cenários sem cobertura estavam entre os aprendizados, desenhei o fluxo completo em sete partes: o caminho principal e seis variações (edição de linha, ações em lote, problemas no envio, validação, resultado com erro e saída sem importar). Se o servidor recusa parte do lote, os aceitos seguem e os recusados mostram o motivo na própria linha. Se a conexão cai na importação, nada do que foi preenchido se perde. Cada tela tem notas sobre o comportamento esperado, como máscaras, validações e tempos. Assim, a passagem para a engenharia passou a fazer parte do design.
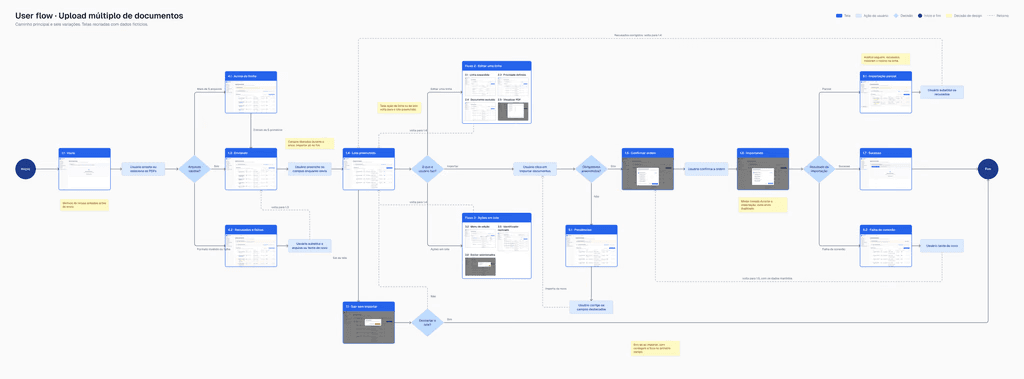
User flow com o caminho principal e as seis variações do upload.
Depois, usei IA para construir um protótipo interativo. Com tantas ações e estados, só um protótipo navegável mostraria o que telas estáticas escondem.
Com ele, fiz um teste moderado com dois usuários que conheciam o processo. Eles pensavam em voz alta enquanto executavam seis tarefas em sequência:
•
enviar os arquivos;
•
preencher um documento;
•
definir uma prioridade;
•
registrar os campos complementares;
•
replicar o identificador;
•
editar vários documentos em lote.
Poucos participantes, de propósito. Eu queria entender onde e por que a interface ainda não conversava com o modelo mental de quem já fazia a tarefa.

Sessão de teste moderado com o protótipo interativo.
O envio passou sem dúvidas, e a edição em lote foi a parte mais elogiada. Três achados mudaram o design.
O nome do arquivo.
O protótipo cortava nomes longos. Um participante explicou o que eu não tinha visto: documentos da mesma empresa têm nomes quase iguais, diferentes só no ano, que fica no final. O corte escondia exatamente o que distingue um arquivo do outro. Agora o nome aparece inteiro.
A seta de expansão.
Na versão testada, ela ficava ao lado do nome do arquivo, pequena e sem rótulo. Os dois participantes passaram por ela sem perceber que havia campos escondidos ali. Depois do teste, o controle ganhou coluna própria e um tooltip explicando o que faz.
O identificador "outro".
Para empresas sem CNPJ, o campo só aceitava números. Na prática, os usuários combinavam um tipo de identificação, como CPF, com o valor. O campo passou a aceitar letras e números e virou dois: tipo e valor.
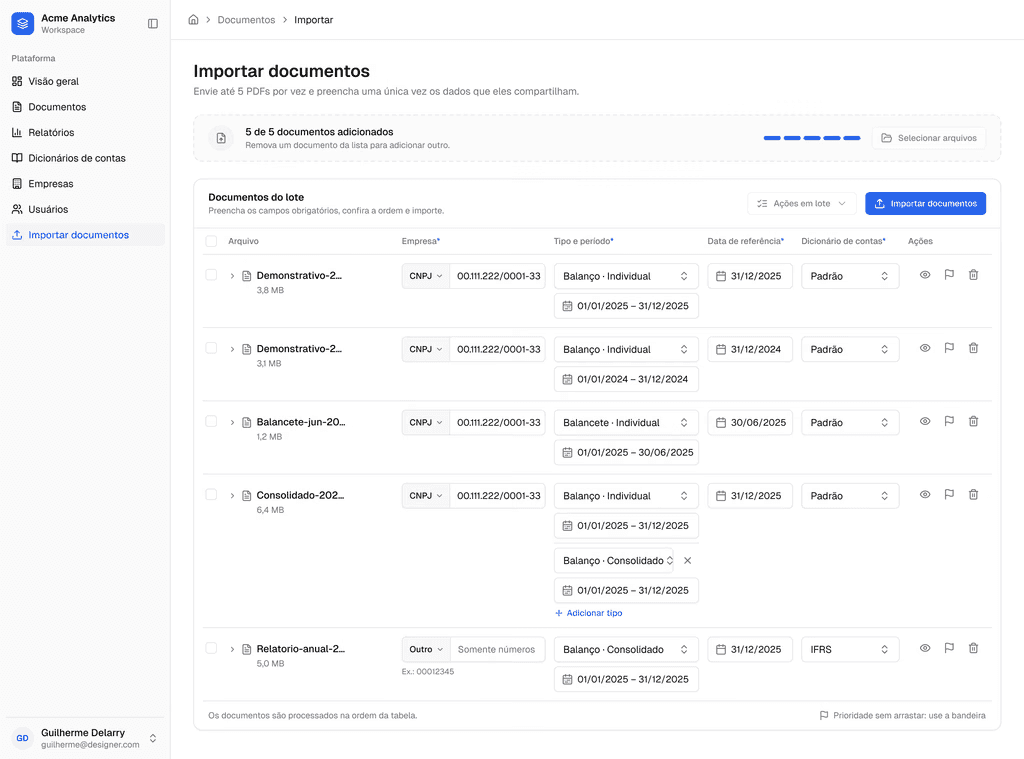
Versão testada: nome do arquivo cortado, seta de expansão discreta e identificador “outro” só com números.
Ficou uma pergunta aberta: o limite de tamanho dos arquivos não aparecia na tela. Essa informação precisa ficar perto da área de upload.
Decisões e trade-offs
Registrei cada decisão com fundamento, origem da evidência e forma de validar. Estas mudaram mais a experiência.
Preencher enquanto envia.
Cada arquivo mostra o próprio progresso, e os campos ficam liberados durante o envio. Ninguém fica olhando barra de carregamento.

Cada arquivo mostra o próprio progresso, e os campos já podem ser preenchidos durante o envio.
Controle de expansão em coluna própria.
Avaliei colocar o botão dos campos complementares na coluna Ações, junto de prioridade e exclusão. Descartei: ficava longe dos campos que abria, e o estado aberto era pouco visível. Ele foi para uma coluna própria, colado à linha e separado do checkbox, para reduzir cliques errados.

Alternativa descartada: o botão de expandir na coluna Ações ficava longe dos campos que abria.
Prioridade sem arrastar.
O prazo de processamento importava para os clientes, então o analista precisava decidir o que sai primeiro. Arrastar para reordenar seria o óbvio. Só que o arrasto falha para quem navega por teclado (WCAG 2.5.7) e complicava o fluxo. Marcar prioridade leva o item direto para a posição 1, com um aviso confirmando a nova ordem.

Prioridade sem arrastar: o documento vai para o 1º lugar e um aviso confirma a nova ordem.
Confirmar a ordem, mas não para sempre.
Havia pedidos opostos registrados no projeto: um para tirar o modal de confirmação, outro para usá-lo na conferência da ordem. Fiquei com o modal, porque errar a ordem custa minutos de processamento, e acrescentei "não exibir novamente nesta sessão" para quem já confia no fluxo.

Confirmação da ordem de processamento, com a opção de não exibir de novo na sessão.
Como vou saber se funcionou
Ainda não há números de impacto para compartilhar. Há hipóteses e um jeito de testá-las.
Os indicadores definidos:
•
tempo médio para enviar os arquivos;
•
quantidade de documentos enviados por período;
•
percepção dos usuários na pesquisa de satisfação;
•
comportamento antes e depois.
E as perguntas que mais me intrigam. Quantos analistas vão usar a edição em lote em vez de editar linha por linha? Quantos vão descobrir o "Replicar identificador" sem ninguém contar? As recusas por arquivo duplicado ou ilegível vão cair agora que o aviso aparece antes do envio?
O que mais importa é se o esforço operacional cai. Completar o fluxo não basta.
O que eu faria diferente
Olhando de volta, três coisas eu mudaria:
Medir antes de desenhar.
Eu sabia que o fluxo era repetitivo, mas não medi quanto tempo um lote levava do jeito antigo. Sem essa linha de base, comparar o depois fica mais difícil.
Testar de novo logo depois dos ajustes.
Mudei o nome do arquivo e a seta de expansão a partir do teste, mas ainda não voltei aos usuários para confirmar se a nova versão resolveu. [preencher, se mudou: reteste feito ou agendado]
Levar os casos de borda para a engenharia ainda no rascunho.
As notas de comportamento ajudaram na passagem, mas mostrar os fluxos de erro mais cedo teria antecipado as dúvidas de implementação.
O que fica
A primeira tentativa mostrou o custo de mudar demais. Esta mudou só onde havia repetição e deixou o resto onde os analistas esperavam encontrar. Às vezes, o movimento mais ousado num redesign é saber onde não mexer. Se der certo, ninguém vai comentar a tela nova.
Chegou até o fim da bancada. Pode pegar uma etiqueta.